Palantir, Microsoft en Google publiceren in 2026 drie architecturen voor bedrijfs-AI die uitdrukkelijk op een ontologie rusten. Vijfentwintig jaar na het stichtende artikel over het semantische web. Hier leest u waarom die wending voorspelbaar was, wat ze technisch inhoudt, en hoe een uitvoering eruitziet die vandaag echt beschikbaar is.
1. Drie signalen die samenvallen, in enkele maanden
Het vocabulaire van de platformen is veranderd.
Palantir zet de Ontology in het hart van de AIP-architectuur. De documentatie beschrijft ze als het modelleren van de « zelfstandige naamwoorden » en de « werkwoorden » van de bedrijfsprocessen, in een vorm die zowel mensen als agenten kunnen lezen, en kondigt een motor aan die « miljarden objecten kan bevragen, tienduizenden acties kan orkestreren en voortdurend leren uit ervaring kan inbouwen » [1].
Microsoft voert een item Ontology in binnen Fabric IQ, in voorvertoning. De officiële documentatie is duidelijk: de ontologie « definieert de fundamentele bedrijfsentiteiten, de relaties, de eigenschappen, de regels en de acties », en « agenten begrijpen welke acties beschikbaar zijn en hoe ze die moeten aanroepen » [2]. Een laag NL2Ontology zet vragen in natuurlijke taal om in gestructureerde zoekopdrachten.
Google Cloud documenteert het geval Yahoo: een agentisch platform voor media-inkoop, gebouwd op twee afzonderlijke grafen. Een knowledge graph in Spanner Graph draagt de operationele waarheid, producten, voorraden, contracten, bestuurscontroles, met het beleid ingeschreven als relaties met versienummer in plaats van begraven in de toepassingslogica. Een context graph in BigQuery Graph draagt een ontologie van het beslissingsspoor, dat wil zeggen de controleerbare afstamming van elke afweging die de agent maakt [3].
Drie spelers, drie architecturen, één zelfde intuïtie. En een formulering die het onthouden waard is, die van Swapnil Patel (Yahoo): « Naarmate de sector opschuift van systemen van inzicht naar systemen van actie, verschuift de beperking op autonome AI van het vermogen van het model naar de vraag of een onderneming kan vertrouwen op wat een agent doet zonder toezicht » [3].
2. Wat die platformen herontdekken, werd in 2001 al vastgelegd
Niets daarvan is nieuw op begripsmatig vlak.
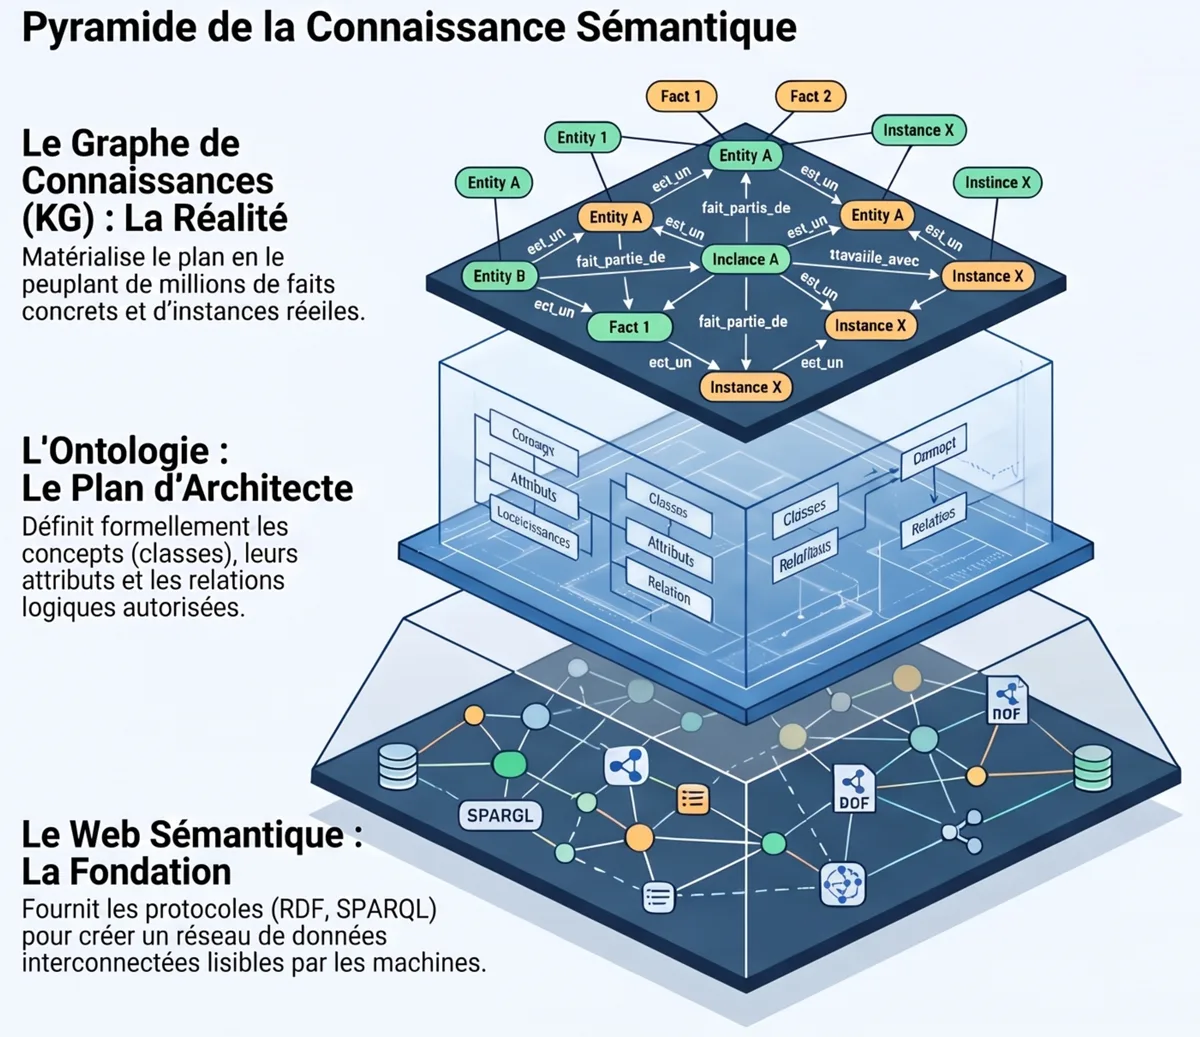
Tim Berners-Lee, de uitvinder van het web, legt in mei 2001 in Scientific American, samen met James Hendler en Ora Lassila, het idee vast van een web waarvan de gegevens door machines te lezen zijn. In 2007 maakt hij de uitdrukking Giant Global Graph bekend: niet langer een netwerk van documenten verbonden door links zonder betekenis, maar een netwerk van getypeerde feiten.
De technische stapel die daaruit volgt, ligt al lang vast: URI voor de identiteit, RDF voor het drietal onderwerp, predicaat, object, RDFS en OWL om te verklaren wat er kan zijn, SPARQL om te bevragen. OWL wordt Aanbeveling van het W3C in 2004, OWL 2 in 2009, tweede uitgave in 2012.
Aan Franstalige kant van de kennistechniek legden Charlet, Bachimont en Troncy al in 2004 de definities vast die nog altijd gezag hebben [4]. Twee daarvan verlichten het huidige debat rechtstreeks:
« Een ontologie bouwen betekent ook beslissen over de wijze waarop de objecten zijn en bestaan. »
« Een ontologie is een specificatie die gedeeltelijk rekenschap geeft van een begripsvorming. »
Dat « gedeeltelijk » is geen retorische zwakte. Het benoemt de ontologische verbintenis: de aanvaarde afstand tussen de rijkdom aan betekenis van een domein en wat een berekenbare logische theorie daarvan kan vastleggen. Het is precies de vraag die een architect zich vandaag stelt wanneer hij beslist welke acties een agent mag uitvoeren.
Diezelfde auteurs beschreven toen al het bouwen van ontologieën vanuit tekstcorpora, in vier stappen waarvan de eerste de voorrang van het corpus is en de tweede de semantische normalisering. Tweeëntwintig jaar later is dat precies de verwerkingslijn die opnieuw wordt uitgerold, met een statistische extractor erbij.
3. Waarom nu: de LLM's halen de economische grendel weg, en scheppen de behoefte
Het historische probleem van de ontologie was nooit theoretisch. Het was economisch.
Een ontologie bouwen vroeg een kennisingenieur en een domeindeskundige, op een lange keten: de begrippen vaststellen, de klassen bepalen, de rangorde, de relaties, de beperkingen, uitlijnen, valideren, onderhouden. Te duur voor de meeste organisaties. Het gevolg: een methode die als uitstekend geldt, en weinig wordt toegepast.
De LLM's verplaatsen die grendel op twee tegengestelde en aanvullende manieren.
Stroomopwaarts drukken ze de schrijfkosten. Begrippen halen uit tekst, entiteiten en relaties halen uit tekst, een schema schetsen, een eerste OWL-weergave voortbrengen: evenveel stappen die nu worden ondersteund. Werk dat in 2025 en 2026 is verschenen, meet die ondersteuning op reeksen bekwaamheidsvragen, met een genuanceerde uitkomst: de modellen dekken meer vragen dan beginnende studenten, maar brengen nog altijd onjuiste axioma's en overbodige elementen voort. De ondersteuning is echt; de validatie blijft menselijk en gereedschapsgebonden.
Stroomafwaarts scheppen ze de behoefte. Een taalmodel heeft geen stabiel wereldmodel. Geplaatst voor het documentaire erfgoed van een onderneming kan het niet zelf beslissen over vragen die nochtans de structuur bepalen: duidt Rekening op een bankrekening of op een klantenrekening? Is de relatie Klant naar Rekening 1:N of N:N? Kan een geannuleerde bestelling nog een verzending dragen? Mag een verkoper een contract wijzigen? Die antwoorden kunnen niet uit de voorkennis van het model komen. Ze moeten komen uit een uitdrukkelijke verklaring, gedeeld en met versienummer.
En met de agenten verandert de inzet van aard. Een gespreksassistent die zich licht vergist, brengt een fout antwoord voort. Een agent die zich licht vergist, voert bestelling_annuleren(), geld_overmaken(), leverancier_wisselen() uit. Daarmee komen we terug bij een klassiek idee uit de AI: World Model plus Action Model.
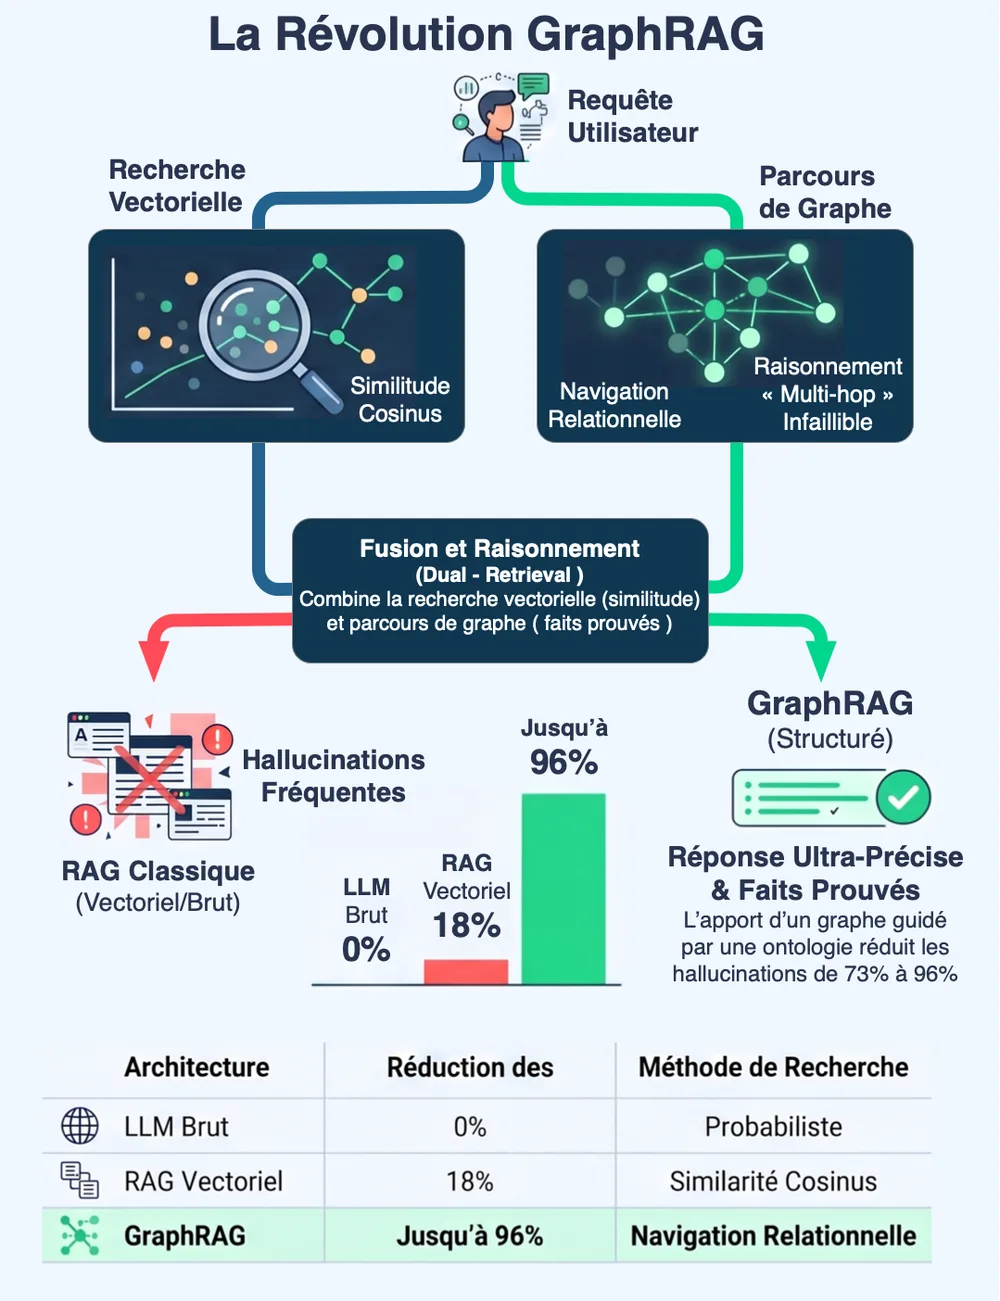
Eén punt verdient nadruk, want het wordt op de netwerken massaal verward: GraphRAG is geen ontologie. De standaard indexeringsketen van Microsoft GraphRAG laat een LLM entiteiten en relaties halen uit tekst, bouwt een graaf, spoort hiërarchische gemeenschappen op (Leiden) en brengt gemeenschapsverslagen voort. Er is stroomopwaarts geen enkele OWL-ontologie vereist. De juiste formulering luidt: GraphRAG geeft een graaf aan het LLM; de ontologie geeft aan die graaf een stabiele betekenis.
4. Wat dat een architectuur concreet oplegt
Als we de drie voorbeelden uit deel 1 ernstig nemen, moet de semantische laag aan vijf eisen voldoen, en niet aan één:
- Een verklaard vocabulaire, van vóór de inname, in een standaardformaat dat een vakdeskundige kan nalezen;
- Een tegenwerpbare grens tussen wat het model voorstelt en wat het systeem toelaat;
- Een vergrendeling op versie: weten onder welke ontologie een gegeven is voortgebracht, en onder welke ontologie een antwoord is opgesteld;
- Een controleerbare afstamming van de beslissing, los van de kennisgraaf zelf, dat is de les van de dubbele graaf van Yahoo;
- Een bestuur van de rechten ingebouwd in de betekenis, niet er achteraf aan toegevoegd.
Dat is een bestek van een architect, geen verkooppraat van een uitgever. Het valt in de code na te gaan, of het valt niet na te gaan.
5. BrainDup: hetzelfde model, soeverein, en al uitgevoerd
BrainDup is de KG-RAG-basis die AS3P ontwikkelt. Het ontwerp dateert van vóór de aankondigingen van 2026 en volgt precies dezelfde lijn. De onderstaande elementen zijn na te gaan in het codebestand.
De ontologie staat in OWL, niet in configuratie. Elk domein wordt beschreven in een Turtle-bestand (TTL) dat klassen, eigenschappen, domeinen en bereiken verklaart, plus een eigen reeks annotaties (bdup:) die de projectie naar de basis, de deterministische identiteit en de aanwijzingen voor extractie dragen. De algemene basis POLE+O toont vijf universele bouwstenen, Persoon, Organisatie, Plaats, Gebeurtenis, Object; de vakpakketten vervangen die niet, ze verbijzonderen ze met meervoudige labels. Het erfgoedpakket, in productie op een corpus van 921 documenten uit de streekpers, verklaart 19 types, 17 relaties en 4 soorten gebeurtenissen, uitgelijnd op CIDOC CRM (ISO 21127) en RiC-O. Het verzekeringspakket is gebouwd op LKIF, aangevuld met de institutionele theorie (ruwe feiten tegenover institutionele feiten, instanties, regelingen, dingen, en de levenscyclus instellend, gevolggevend, beëindigend).
De TTL wordt gecompileerd, nooit warm geïnterpreteerd. rdflib leeft tijdens de build en komt niet in de runtime. Het compileren brengt een JSON-manifest voort dat wordt gevalideerd door een gesloten contract (extra="forbid" op elk niveau): een sleutel buiten het contract wordt niet genegeerd, ze wordt geweigerd. De grens tussen het wat te halen uit tekst (verklaard door het pakket) en het hoe (drempels, verankering van passages, mechaniek van gebeurtenissen, gemeenschappelijke code) wordt structureel en niet afspraakgebonden.
Het compileren is een kwaliteitscontrole, geen omzetting. Vier families van blokkerende controles gelden voor de TTL: identificatoren zonder accent, verplicht Frans label op elke getoonde relatie, samenhang van domeinen en bereiken, hangende gelijkwaardigheden, eigenschap die naar zichzelf wijst, instanties buiten het verklaarde domein. Een pakket dat zakt, wordt niet afgezwakt, het wordt niet gecompileerd. En een TTL die wordt gewijzigd zonder hercompilatie laat de doorlopende integratie zakken, nooit de productie.
Het pakket wordt vergrendeld bij de geboorte van het corpus. De actieve ontologie is geen configuratieveld maar een INSERT-only-journaal in de databank: de toestand volgt uit de laatste gebeurtenis. Elke innametaak draagt de ontology_epoch waaronder ze in de wachtrij is gezet, en de worker weigert een taak uit een ander tijdvak te behandelen. Een SHA-256-afdruk van het manifest wordt bij het opstarten vergeleken: als het geactiveerde pakket sindsdien is hercompileerd, weigert het proces te projecteren in plaats van twee vocabulaires in één graaf te mengen. Dat is bewust fail-closed-gedrag.
Het antwoordspoor draagt de ontologie. Elk voortgebracht antwoord legt niet alleen de gebruikte passages, entiteiten en relaties vast, maar ook de identificator en de versie van de ontologie waaronder het proces heeft geantwoord. Dat is, op de schaal van een documentaire basis, het equivalent van de context graph van Yahoo: de afstamming van de beslissing, gescheiden van de kennisgraaf.
Het leidende beginsel past in één zin: het LLM stelt voor, de code beslist. Het model haalt uit tekst en stelt op. De deterministische code beslist: een entiteit komt alleen in de graaf als ze overeenkomt met een type dat het pakket verklaart en als ze te verbinden is met een welbepaalde passage uit het bronbestand. De bronvermeldingen worden door de code samengesteld uit de catalogus, nooit door het model opgesteld. Nul gevonden passages betekent een eerlijke weigering, zonder het LLM zelfs maar aan te roepen. Proza zonder vaststaande passage betekent eveneens een weigering.
Drie databanken, één enkel semantisch contract. PostgreSQL draagt de transactionele waarheid, de rechten, de versies en de audit; Neo4j draagt de graaf; Milvus draagt het vectoriële geheugen. Dat zijn geen drie silo's maar drie projecties van eenzelfde contract. De rechten horen daarbij: methode AGDLP, één enkele beslissingsdienst, daarna eigen toepassing per databank, voorfiltering van de vectoren, in de graaf voortgebrachte veiligheidsclausules, Row-Level Security in SQL. Een recht intrekken werkt meteen door het verwijderen uit een groep, zonder herindexering.
Het geheel is soeverein. Lokale inferentie, geen enkel gegeven uit het corpus naar een derde partij, soevereiniteitscontrole bedraad in de keten van doorlopende integratie, uitrol mogelijk in een ontkoppelde omgeving.
6. Tabel van overeenkomsten
| Eis | Palantir AIP | Fabric IQ | Yahoo / Google | BrainDup |
|---|---|---|---|---|
| Verklaard bedrijfsvocabulaire | Ontology | Ontology (voorvertoning) | Getypeerde graafontologie | Gecompileerd OWL/TTL-pakket |
| Acties en regels | Acties van eerste rang | Regels en acties | Beleid als relaties met versienummer | Gesloten contract plus codebewaking |
| Verankering van de agenten | Ontology SDK | Gestructureerde grounding, NL2Ontology | Spanner Graph | KG-RAG, bronvermeldingen door code samengesteld |
| Afstamming van de beslissing | Doorlopend leren uit ervaring | Bestuur van de definities | Context graph, BigQuery | Vraagspoor gestempeld met de ontologie |
| Soevereiniteit en hosting | Cloud van de uitgever | Cloud van de uitgever | Cloud van de uitgever | Lokaal, soeverein, af te koppelen |
7. Wat BrainDup niet doet, en waarom we dat zeggen
De geloofwaardigheid van een basis blijkt ook uit de doelen die ze uitdrukkelijk niet nastreeft.
BrainDup bevat geen OWL-redeneermotor in de runtime. De transitieve afsluitingen worden berekend door afleiding in code, uitdrukkelijk en te testen, in plaats van overgelaten aan een redeneerder wiens gedrag afhangt van de netheid van de gegevens. Dat is een afweging tussen zeggingskracht en voorspelbaarheid, bewust gemaakt en gedocumenteerd.
BrainDup streeft niet naar het wereldwijde semantische web. Het voorwerp is een besloten kennisgraaf, begrensd tot het corpus van één organisatie. Berners-Lee mikte op een graaf van de hele planeet; de geschiedenis heeft getoond dat het semantische web zich heeft verwezenlijkt in eilanden, daar waar strengheid van levensbelang is: gezondheidszorg, recht, financiën, erfgoed, industrie. BrainDup bouwt zo'n eiland, per organisatie.
Tot slot is de catalogus van vakpakketten ongelijk rijp: twee pakketten zijn gecompileerd en operationeel, acht andere zijn gemodelleerd in TTL en wachten op hun ronde graafannotaties. Het werk dat rest is modellering, geen software-engineering, en het laat zich becijferen.
8. Besluit
De auteur van het artikel dat deze notitie heeft aangezet, besluit als volgt: de toekomst is waarschijnlijk geen eenvoudige terugkeer naar OWL, maar een semantische en operationele laag die op de ontologie steunt en domeinmodellen, lopende gegevens, actiecontracten, beleid en uitvoeringscontroles verbindt; een soort « semantisch besturingssysteem » tussen de AI's en de middelen van de onderneming.
Dat is een goede beschrijving. Het is ook, woord voor woord, wat een bestuurde KG-RAG-basis vandaag al uitvoert, op een schaal die niet die van een hyperscaler is maar die van een kmo, een kantoor, een lokale overheid of een gereglementeerd beroep.
De vraag die in 2026 aan de directies wordt gesteld, is dus niet langer « hebben we een ontologie nodig ». Ze luidt: wie bezit de uwe, waar draait ze, en kunt u vraag per vraag bewijzen onder welke versie ze heeft geantwoord?
Om die eisen te toetsen aan uw eigen documentaire erfgoed, maak een afspraak of schrijf ons.
Bronnen
- Palantir, AIP Architecture, Foundry Architecture Center. palantir.com
- Microsoft, What is Fabric IQ?, Microsoft Learn. learn.microsoft.com
- Google Cloud, Graph technologies underpin Yahoo's system of action, juni 2026. cloud.google.com
- J. Charlet, B. Bachimont, R. Troncy, Ontologies pour le Web sémantique, tijdschrift I3, themanummer semantisch web, 2004, in het Frans. HAL: hal-03854420
- T. Berners-Lee, J. Hendler, O. Lassila, The Semantic Web, Scientific American, mei 2001; T. Berners-Lee, Giant Global Graph, 2007.
- W3C, OWL Web Ontology Language (Aanbeveling 2004), OWL 2 (2009, tweede uitgave 2012).
- Overzichtsartikel Why Ontology Is Making a Comeback in the Age of LLMs (2026), voor de verwijzingen ESWC 2025, EMNLP 2025 (OG-RAG), ACL 2025 (ORT) en ACL 2026 (OntGQA).
Lees ook
- Soevereine bedrijfs-AI: BrainDup blijft bij u
- AI Act: hoe BrainDup antwoordt, artikel per artikel
- Meertalige multimodale RAG: waarom uw AI uw Nederlandse documenten negeert
Jean-Marc André, AS3P. BrainDup is een soevereine KG-RAG-basis voor organisaties die moeten kunnen bewijzen wat hun AI beweert.
Eerst verschenen op as3p.nl, de algemene site van AS3P.